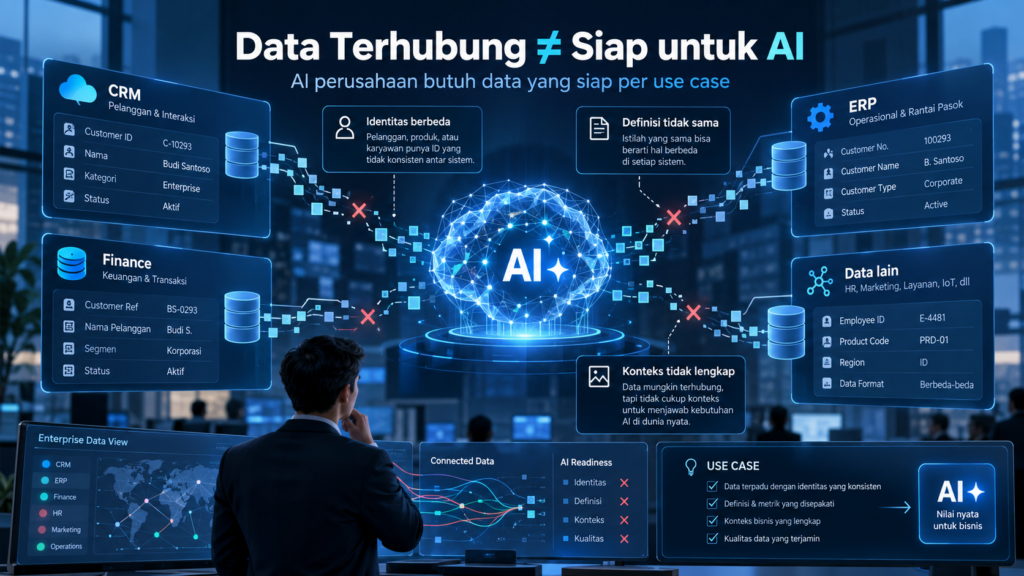
Data terhubung belum otomatis siap untuk AI. Identitas pelanggan, arti data, riwayat, metadata, dan hak akses harus sesuai dengan keputusan bisnis yang ingin dibantu. Data silo merupakan salah satu gejala; integrasi aplikasi saja belum menyelesaikan semuanya.
Gartner, 26 Februari 2025, memprediksi organisasi akan menghentikan 60% proyek AI yang tidak didukung AI-ready data hingga 2026. Ini prediksi untuk kelompok proyek tersebut, bukan tingkat kegagalan seluruh AI perusahaan. Publikasi yang sama menyebut 63% organisasi belum memiliki atau tidak yakin memiliki praktik manajemen data yang tepat untuk AI.
Gartner juga menjelaskan data tersebar dalam silo lintas repositori, sistem, dan platform, serta metadata yang belum memadai untuk menilai kesiapan. Karena itu, keputusan awalnya adalah: use case apa yang akan dibantu, dan data apa yang diperlukan?
Data Silo Memecah Konteks Bisnis
Untuk menilai risiko pelanggan berhenti, perusahaan mungkin membutuhkan CRM, ERP, pembayaran Finance, keluhan, penggunaan layanan, dan kontrak. Masing-masing memiliki informasi, tetapi identitas atau definisinya berbeda.
Contoh berikut ilustratif:
| Sistem | Identitas | Informasi |
|---|---|---|
| CRM | ABC Corp | Status aktif |
| ERP | ABC-001 | Order Rp2,4 miliar |
| Finance | 88921 | Tagihan lewat jatuh tempo Rp350 juta |
Tanpa pemetaan, model dapat menilai pelanggan sehat dari status dan order, tetapi melewatkan tunggakan. Tagihan yang belum jatuh tempo tidak otomatis merupakan sinyal risiko yang sama. Arti data memengaruhi kesimpulan, bukan hanya keberhasilan koneksi.
Silo juga bertahan karena sistem, anggaran, dan KPI departemen terpisah. IBM tentang fragmentasi data membahas dimensi organisasi tersebut. Pemilik proses lintas fungsi harus menetapkan siapa menyelesaikan konflik definisi; IT tidak dapat memutuskan makna bisnis sendirian.
CONNECT Sesuai Use Case
Tidak perlu menunggu semua aplikasi terintegrasi. Hubungkan sumber yang diperlukan use case pertama, validasi, lalu perluas. CONNECT merupakan salah satu pilar Sagara bersama BUILD, UPGRADE, dan AUTOMATE; tidak ada urutan universal.
Untuk masalah identitas, gunakan master data management atau entity resolution. Warehouse atau lakehouse menyimpan riwayat; katalog data mencatat definisi, pemilik, asal, dan kualitas. API atau pipeline memasok data ke komponen tersebut sesuai toleransi keterlambatan. Rincian integrasi aplikasi dan rekap laporan ada dalam integrasi sistem untuk mengurangi rekap laporan manual.
| Jenis AI | Kebutuhan data |
|---|---|
| Prediktif, seperti churn | Riwayat sebelum pelanggan berhenti, definisi target, dan fitur yang tersedia pada waktu prediksi |
| GenAI, seperti asisten kontrak | Dokumen, versi, sumber, serta retrieval yang mengikuti izin pengguna |
GenAI dapat memerlukan chunking, embedding, vector store, dan RAG sesuai kebutuhan; Gartner membahas kebutuhan ini. Penyimpanan vektor tidak menyelesaikan izin atau kesalahan identitas dengan sendirinya.
Enam Langkah Menyiapkan Data
1. Pilih Keputusan dan Baseline
Pada contoh churn, tetapkan keputusan tim retensi yang akan dibantu, cara kerja saat ini, dan ukuran keberhasilannya. Petakan transaksi, pembayaran, keluhan, penggunaan, dan kontrak yang relevan serta batas umur datanya.
2. Tetapkan Sumber dan Pemilik per Atribut
ERP atau Finance dapat memiliki identitas legal dan pembayaran; CRM memiliki kontak serta riwayat hubungan. Jangan mengasumsikan CRM selalu sumber seluruh identitas. Tetapkan pihak yang menyelesaikan perbedaan serta aturan koreksinya.
3. Samakan Identitas, Definisi, dan Riwayat
Petakan ABC Corp dengan kode ERP dan Finance menggunakan pengenal tepercaya, seperti NPWP atau nomor kontrak tervalidasi. Kemiripan nama saja tidak cukup.
Samakan pajak, mata uang, dan tanggal perhitungan tunggakan. Definisikan churn: kontrak tidak diperpanjang, tidak ada pembayaran 90 hari, dan akun ditutup merupakan target berbeda. Sinkronisasi status terkini kehilangan kondisi sebelum churn. Jangan memakai informasi yang baru diketahui setelah kejadian sebagai fitur training.
4. Pilih Aliran yang Sesuai Keputusan
Skor churn bulanan dapat memakai pipeline harian bila bisnis menerima umur datanya. Fraud saat transaksi membutuhkan feed dengan latensi sesuai tenggat keputusan. Tetapkan penanganan kegagalan, duplikat, dan rekonsiliasi.
Untuk legacy tanpa API, pertimbangkan ekspor terjadwal, adapter, atau CDC. Periksa izin serta lisensi vendor, beban database produksi, dan keterlambatan sebagaimana memperbaiki legacy system tanpa menghentikan operasional.
5. Periksa Kualitas, Metadata, dan Izin
Periksa duplikasi, nilai kosong, format, dan data kedaluwarsa. Catat definisi, sumber, pemilik, transformasi, serta waktu pembaruan dalam metadata. Hak akses pengguna harus berlaku saat mengambil dokumen untuk GenAI.
UU PDP Pasal 16 ayat (2) memuat prinsip tujuan pemrosesan, akurasi, dan perlindungan dari akses tidak sah. Terapkan pengambilan data sesuai tugas dan kewenangannya.
6. Uji Mundur dan Pantau Perubahan
Gunakan data enam bulan lalu dengan informasi yang tersedia saat itu. Bandingkan daftar pelanggan berisiko dengan churn aktual dan metode tim sebelumnya. Periksa identitas yang salah serta ketepatan daftar sebelum menggunakannya untuk tindakan retensi.
Pantau kualitas, schema, dan lag setelah pilot. Koneksi berhasil tidak membuktikan prediksi berguna; kesiapan data perlu dievaluasi ulang saat kebutuhan berubah.
FAQ
Haruskah AI menunggu semua sistem terintegrasi?
Tidak. Pilih sumber bagi satu use case dengan definisi, pemilik, dan izin yang jelas.
Bagaimana mengetahui data sudah AI-ready?
Buktikan kelengkapan, representasi use case, kualitas, riwayat, dan izin lewat pengujian hasil. Penilaiannya khusus bagi kebutuhan tersebut.
Apakah semua data harus dipindahkan ke satu database?
Data relevan untuk analitik atau training dapat dikumpulkan ke warehouse. Semua data operasional tidak harus dipindahkan.
Mulai dari Keputusan Bisnis
Sagara Xinix – Solusi Teknologi Terintegrasi dan Terpercaya menyediakan perancangan sistem dan integrasi yang dapat dimulai dari kebutuhan data tersebut. Bawa satu use case beserta sumber data dan baseline-nya ke diskusi dengan Sagara.